4B 的 Qwen3.5-3D-Coder 专写 Three.js 场景,还能照着图片搭
开发者 CCORE 基于 Qwen3.5-4B 独立微调的 3D-Coder 模型专注生成可交互的 Three.js 3D 场景,10 月底又加了看图生成能力,GGUF 格式一张消费级显卡就能跑。
相关标签
4B 的 Qwen3.5-3D-Coder 专写 Three.js 场景,还能照着图片搭
摘要:开发者 CCORE 基于 Qwen3.5-4B 独立微调的 3D-Coder 模型专注生成可交互的 Three.js 3D 场景,10 月底又加了看图生成能力,GGUF 格式一张消费级显卡就能跑。
当各家实验室都在卷万亿参数 MoE 的时候,榜单上出现了一个反方向的作品:Qwen3.5-4B-3D-Coder,一个只有 4B 参数、还在训练中的小模型,专注一件事——生成可交互的 Three.js 3D 场景。
先说清楚出身:这是开发者社区 CCORE 基于 Qwen/Qwen3.5-4B 做的独立微调,不是 Qwen 官方发布。作者的定位是一个训练实验,探索小模型能不能同时干好两件事:通用编码,以及高质量 3D 场景生成。目前放出的 early preview 反馈不错,于是决定边训边分享。训练用了专门的 ThreeJS-3D-Scenes 数据集,模型卡上还挂着一份已发布的技术报告 PDF。
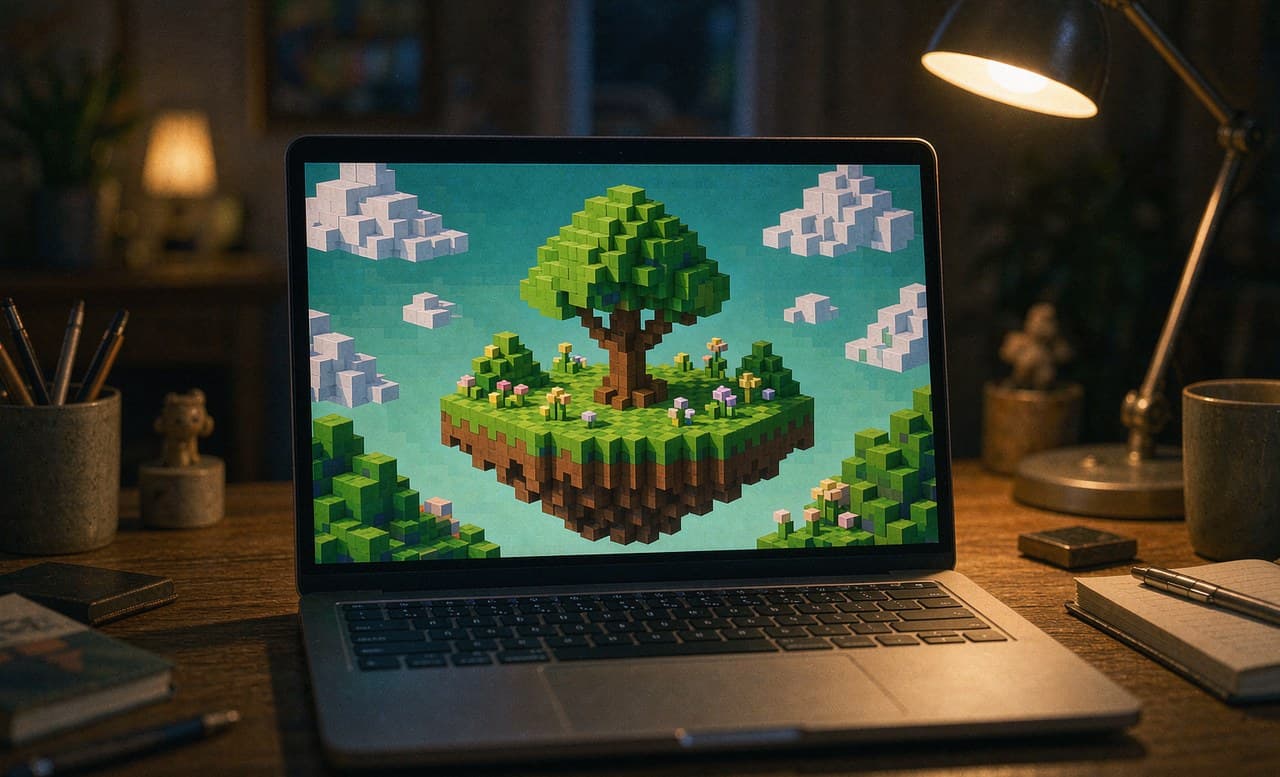
真正让它出圈的更新是 10 月 30 日加入的可选视觉支持:Q4_K_M 和 Q8_0 两个 GGUF 量化版本,配合原版 Qwen3.5-4B 的视觉投影器(BF16,约 644 MiB,下载一次两个量化版通用),就能接收图片输入。效果是你可以贴一张参考图,让模型照着生成对应的 Three.js 场景——官方示例里,一张”漂浮岛上的橙色体素树”的参考图,配上 Three.js 系统提示词,用户提示只有一句”create this scene using voxels 3d”。作者也坦白这是定性示例,模型是对参考图的诠释而不是逐像素复刻。
这里其实对应一个具体痛点:让通用大模型写 Three.js,最常见的失败不是不会 API,而是空间关系崩掉——光照、相机、物体嵌套一复杂就开始糊。用一个垂直数据集做微调,等于是把”场景该怎么组织”的先验压进 4B 参数里,模型输出的不再是零散代码片段,而是能直接跑起来的一整个场景。
部署门槛相当友好:GGUF 格式走 llama.cpp,实测版本 b11889。llama-server 加上模型 GGUF 和 --mmproj 投影器两个文件就能起服务,64K 上下文配置,KV-cache 还可以用 q8_0 进一步省内存。起服后打开 WebUI、贴图、发提示词,就能看到场景代码跑起来。需要注意的是,投影器加载会额外占内存,图像 token 也跟提示词、生成的代码共用同一个上下文窗口——图越大、场景越复杂,留给输出代码的余量就越少,这也是作者强调”这些只是短测、不是满上下文压力测试”的原因。
这个模型的观察价值在于它的路径:不追通用榜、不堆参数,用 4B 的体量押注一个足够窄的场景(Three.js 交互式 3D),再把”看图生成”这个直观的演示能力补上。对于想做 3D 内容原型、或者想在本地小显卡上跑一个有用编码助手的开发者,它是一个现成可试的样本;对于研究小模型上限的人,它的技术报告也值得翻翻。作者自己把话说得很明白:早期预览、仍在训练,别指望它替代通用编码模型——它更像一次”垂直微调能走多远”的公开实验。
更多资讯
想看更多优质内容?
浏览所有资讯