一张照片补全看不见的面:Idol 把单图 3D 建模压进 7.2GB 显存
speridlabs 的开源模型 Idol 能把一张物体照片直接变成可交互的 3D 高斯点云,最多输出 1,048,576 个高斯点,在消费级显卡上 2 秒内出结果。
相关标签
一张照片补全看不见的面:Idol 把单图 3D 建模压进 7.2GB 显存
摘要:speridlabs 的开源模型 Idol 能把一张物体照片直接变成可交互的 3D 高斯点云,最多输出 1,048,576 个高斯点,在消费级显卡上 2 秒内出结果。
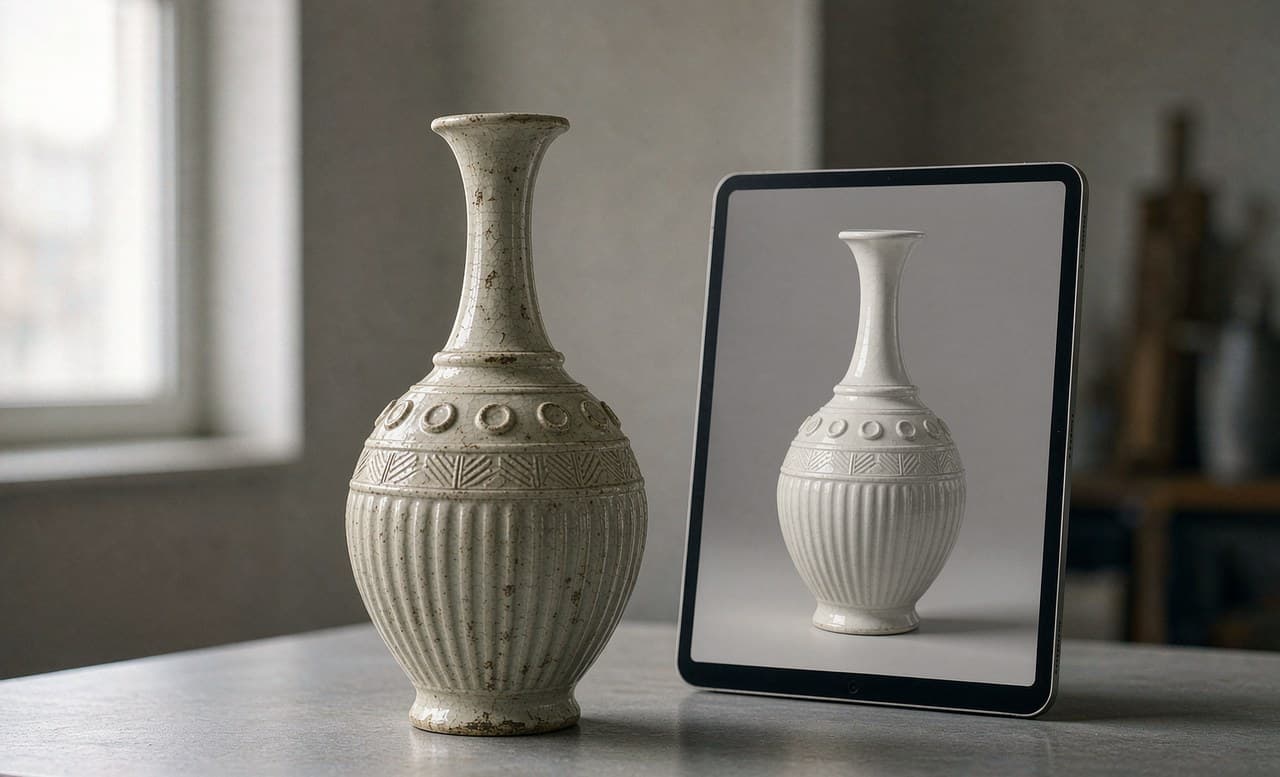
给 3D 建模喂一张照片,最难的不是照着拍到的面建模,而是把照片里根本没拍到的背面、侧面”脑补”出来。新模型 Idol 做的就是这件事:一张物体的照片、渲染图或者 AI 生成图进去,出来一个标准 3DGS 格式的 .ply 高斯点云——最多由 1,048,576 个高斯点组成,连照片没拍到的面也一并补全。
它的工作流程对用户几乎是透明的:模型自动去掉背景、把物体框出来,然后生成点云。输出文件用任意高斯泼溅查看器就能打开,同时还会给出两张”副产品”——去背景裁剪后的输入图 _input.png,以及模型预测的拍摄相机参数 _camera.json,后者意味着生成的 3D 模型和你的拍摄视角是严格对齐的。
对硬件的要求是这个项目最讨喜的地方:7.2GB 显存、单次推理 2 秒以内,一台普通的消费级 NVIDIA 显卡就能跑。权重约 3GB,首次运行时自动下载。唯一的前置手续是 Idol 需要两个 gated 的图像编码器(DINOv3 ViT-H 和 FLUX.2-dev 的 VAE),用户得先在 HuggingFace 上同意对应条款、用 hf auth login 登录一次。
实际使用分两种模式:拍出来的照片走 --mode real(物体占画面 1⁄1.7),渲染图或 AI 生成图走默认的 --mode synthetic(物体占画面 1⁄1.2)。两种模式的区别在于给物体周围留多少裁剪余量。命令行一行 python -m idol.sample --image photo.jpg --mode real 就能出片,也可以走 Python API,连随机种子和高斯点数量都可以自己指定。
环境要求是 Python 3.10+、PyTorch 2.5+ 和一块有 CUDA 的 NVIDIA GPU,代码在 speridlabs/idol-sdk 仓库,pip install -e . 即可安装。如果对 --mode real 的效果不满意,换一张背景干净、物体完整的照片重试——输入质量直接决定点云质量。
值得一提的是它为什么选高斯泼溅而不是传统网格。3DGS 用一堆带位置、尺度、旋转和颜色的椭球来近似物体表面,渲染时直接投影成 2D,天然适合”从少量视角重建”这种信息不完整的场景——这也解释了为什么单张图就能出结果:模型不是在做几何反推,而是在学习”这类物体在三维空间里大概长什么样”,再把缺失的那部分按先验补齐。
在”多视角采集、重管线重建”仍然是 3D 生成主流做法的当下,单图、秒级、消费级显卡这三个词凑在一起,让 idol 成了爱好者最容易上手的一个入口。它同时也是”照片资产化”思路的一次验证:手边一张商品图、一个摆件,就能变成能转、能放进引擎里的三维素材。电商做 3D 展示、独立游戏补道具、扫描类应用做快速预览,都是它能直接插进去的位置——先用一张图拿到可用点云,需要精度时再补拍多视角,成本曲线比一上来就上专业扫描低得多。
限制也要说清楚:它的输入是”单个物体”,去背景和自动构图都是为了把主体抠干净,复杂场景、多物体堆叠、强反光的透明材质不在它的保证范围内;输出是 3DGS 点云,要进传统建模管线还得做一步转换。换句话说,它是一个极快的起点,不是终点。
更多资讯
想看更多优质内容?
浏览所有资讯